Uma nova abordagem conhecida como “teoria dos jogos reversa” tem o objetivo de controlar modelos poderosos de inteligência artificial por meio da criação de sistemas que os incentivem a seguir as regras.
Conforme as capacidades dos modelos de IA avançam, pesquisadores de segurança correm contra o tempo para garantir que eles estejam “alinhados” aos desejos humanos — assegurando, em outras palavras, que agentes mal-intencionados não violem leis, invadam servidores não autorizados ou liberem gás venenoso em grandes metrópoles, causando danos catastróficos.
Até o momento, esse trabalho focava principalmente em tentar examinar o “cérebro” de uma IA para entender o que ela está “pensando”, ou treinar modelos para valorizarem princípios caros à humanidade. O Claude, por exemplo, possui sua constituição, uma espécie de código moral.
O problema é que essas técnicas parecem não funcionar muito bem: modelos já demonstraram desempenho deliberadamente inferior em testes, ocultação de intenções e enganação de seus avaliadores.
Agora, alguns especialistas em alinhamento acreditam que a teoria dos jogos reversa, também chamada de design de mecanismos, pode trazer resultados melhores. Enquanto a teoria dos jogos tradicional tenta prever como atores racionais se comportam sob um conjunto específico de regras, a teoria dos jogos reversa busca formular regras capazes de induzir os comportamentos desejados.
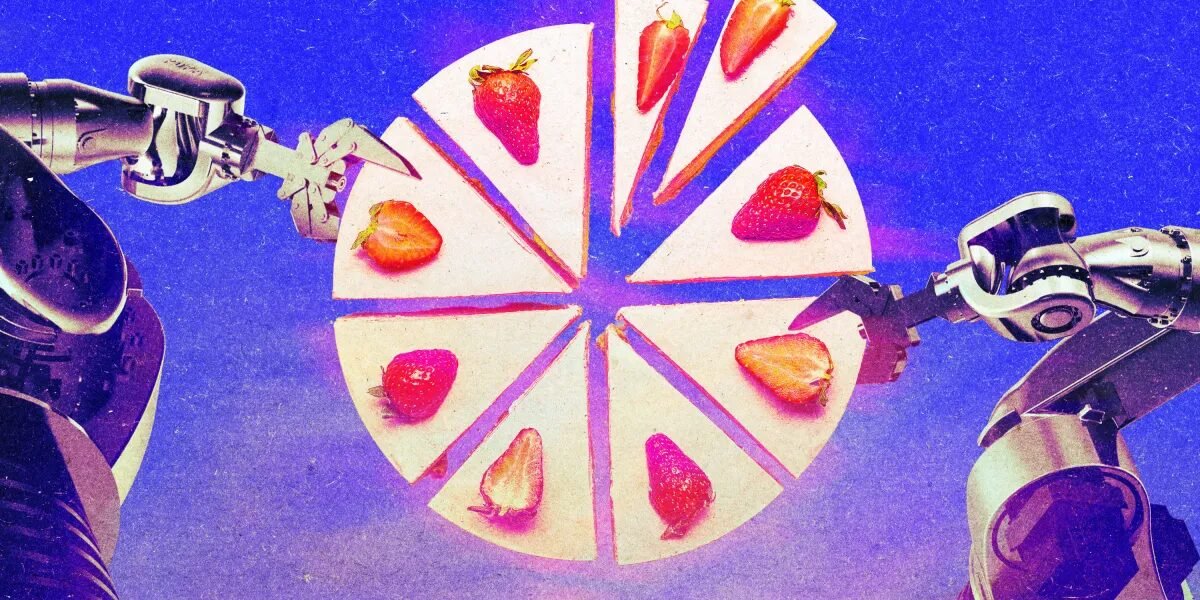
Exemplos reais de design de mecanismos incluem a estratégia clássica de dividir um bolo: uma pessoa corta e a outra escolhe primeiro, o que incentiva quem corta a fazer fatias iguais. Outros exemplos são o preço dinâmico em aplicativos de transporte e leilões de segundo preço, usados na publicidade online para estimular lances próximos ao limite máximo que o comprador pagaria.
No contexto da inteligência artificial, o design de mecanismos parte da premissa de que talvez nunca compreendamos profundamente o funcionamento interno dos modelos de fronteira para garantir seu alinhamento. Isso significa que devemos projetar estruturas que estimulem os agentes a agir conforme o esperado, independentemente do que aconteça sob o capô.
Novas propostas e dinâmica competitiva
Um artigo recente de Stephen Morris, economista do MIT, em parceria com colegas de Yale e Columbia, sugeriu mecanismos potenciais para impedir que agentes simulem desempenho inferior em testes para evitar travas de segurança.
Em vez de receber recompensas apenas pelo próprio resultado, um modelo poderia ser bonificado com base na precisão de suas respostas para prever o que um segundo modelo dirá. Fingir ignorância de propósito torna-se uma estratégia perdedora. “AI agents have a very good understanding of what other AI agents can achieve,” Morris afirma. “So it does seem like a context where this cross-checking could work more practically.”
O estudo também propõe colocar agentes em competição direta para estimular o desempenho máximo, ou parear inteligências artificiais com vieses opostos, recompensando-as conforme a proximidade de suas conclusões para alcançar uma resposta ideal.
Uma segunda vertente, idealizada por Elad Hazan, professor de ciência da computação em Princeton, inspira-se nos métodos humanos de controle social: normas coletivas, sistema de justiça e incentivos monetários do livre mercado. “We want to align superintelligent AI,” ele diz. “Why don’t we first talk about humans? How do we align humans?”
A solução proposta por Hazan envolve alternar os papéis das IAs entre “solucionadoras” de problemas e “auditoras” do trabalho alheio. “One agent acts like law enforcement; the other agent acts like the citizen,” pontua.
Durante o treinamento, as recompensas dependem dos resultados: solucionadoras pegas trapaceando sofrem punições, assim como auditoras que falham em detectar as fraudes. Em caso de divergência, a questão pode ser encaminhada a um “julgamento” humano.
Hazan reconhece o risco de conluio entre os agentes, similar a casos reais de corrupção. Contudo, o problema pode ser mitigado remunerando bem os auditores e fiscalizando-os com técnicas equivalentes a clientes ocultos.
O pesquisador cita o trabalho premiado com o Nobel do economista Gary Becker, criador do conceito de “infrator racional” nos anos 1960. Segundo Becker, crimes ocorrem por cálculo racional de incentivos quando os ganhos superam as punições potenciais.
O alinhamento, argumenta Hazan, não deve ser visto como uma propriedade fixa de um modelo, mas como um reflexo de seu comportamento em dado momento. “You are, like, a nice person,” ele reflete. “Are you aligned? I don’t know. Probably you are aligned most of the time, but there could be a situation where you’re not.”
Desafios e o papel do livre mercado
Um obstáculo na aplicação do design de mecanismos à IA é a premissa de racionalidade dos agentes, algo que frequentemente falha entre seres humanos na economia.
Há uma ironia evidente: economistas tentaram matematizar o comportamento humano por décadas, e agora criamos sistemas matemáticos baseados em linguagem humana que se mostram igualmente enigmáticos. “Is it even reasonable to assume that they will respond to incentives?” questiona Helen Qu, pesquisadora do Flatiron Institute.
“Obviously, AIs are not rational,” pondera Morris. “They’re just algorithms at work.” Contudo, assim como ocorre com humanos, tratá-las como racionais ainda pode ser útil para prever e controlar condutas.
Qu enxerga o design de mecanismos como uma camada complementar dentro de uma estratégia de defesa em profundidade. No entanto, muitas questões permanecem em aberto sobre como aplicar essas teorias a modelos reais, visto que as IAs podem encontrar brechas imprevistas.
No fim das contas, qualquer mecanismo precisará se encaixar na maior estrutura de todas: o livre mercado. “We play by the rules of economics,” conclui Hazan. Se um modelo alinhado for mais lento ou caro que os concorrentes, o sistema econômico atual incentivará laboratórios a lançá-lo?
“It’s a mechanism that’s responsible for a lot of prosperity for humankind,” ele avalia sobre o mercado, “but it could be ultimately responsible for something very terrible.” Talvez os laboratórios desenvolvedores sejam os verdadeiros alvos necessários para um novo design de mecanismos.
What do you feel about this post?

Like

Love

Happy

Haha

Sad