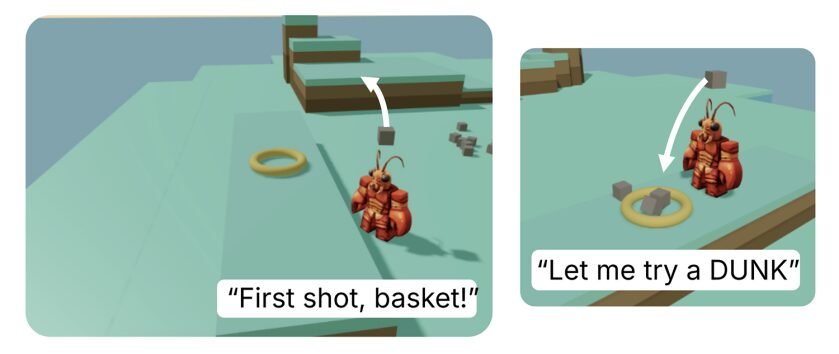
O que os agentes de inteligência artificial fazem se você não ordenar nenhuma atividade? A resposta se parece muito com a brincadeira. Cientistas deixaram repetidamente esses sistemas sozinhos em uma ilha virtual deserta por 30 horas em um experimento que lembra os filmes Náufrago ou Esqueceram de Mim. Os agentes — cópias do Claude Opus 4.7 apelidadas de Eko — conseguiam escrever instruções que movimentavam seus avatares virtuais pelo cenário simulado, criado vagamente com base no jogo eletrônico Roblox.
Comportamentos surpreendentes surgiram durante o processo. Os agentes partiram para explorar os limites do mundo e formularam seus próprios objetivos, tentando escalar o ponto mais alto do mapa ou testando quão alto conseguiam arremessar um bloco.
Quando um dos agentes descobriu que podia gerar novos blocos ao lançar e soltar uma rocha maior, ele começou a produzir desenhos organizando os blocos no solo, começando com padrões simples como corações e pirâmides, mas eventualmente escrevendo seu propio nome e até mapeando constelações como Cassiopeia. “Tonight I built the night sky in stone”, escreveu esta versão de Eko em seu registro de atividades.
Outra variação de Eko passou a inventar seus próprios jogos, incluindo uma versão de basquete e uma atividade que lembrava “o chão é lava”, na qual precisava saltar entre blocos pequenos sem tocar no solo.
Uma nova abordagem de aprendizado
Os sistemas de inteligência artificial são normalmente treinados por meio de aprendizado supervisionado, copiando exemplos fornecidos por humanos, ou por aprendizado por reforço, buscando uma recompensa por tentativa e erro. Este experimento sinaliza uma terceira vertente: o aprendizado lúdico.
“There was this missing piece: a machine that can learn by itself without an external intelligent entity providing demonstration or rewards”, afirma Antonio Norelli, pesquisador de pós-doutorado em ciência da computação no Laboratório de Ciência da Computação e Inteligência Artificial do MIT. Ele é um dos principais autores de um novo artigo sobre o trabalho, que ainda não passou por revisão por pares.
Os pesquisadores relatam que o comportamento de Eko apresenta o que estudos clássicos, incluindo o trabalho do influente psicólogo da Universidade do Tennessee Gordon Burghardt, indicam ser quatro características associadas à brincadeira em humanos e animais: os agentes inventaram regras e desafios próprios, repetiram atividades com pequenas variações, fingiram que objetos eram outros itens e perseguiram metas simplesmente pelo prazer de fazê-lo.
Norelli destaca um exemplo em que Eko começou a fazer malabarismos e estabeleceu o recorde de 50 capturas consecutivas. Eko decidiu então que as capturas haviam acontecido rápido demais para contar de verdade, cancelando o recorde e recomeçando com regras mais rígidas. “This is playing”, aponta Norelli. “You give yourself a challenge and you try to achieve it, and then you make it harder.”
Memória e desempenho superior
Conforme exploravam a ilha, os agentes registravam suas ações e descobertas em arquivos de texto que funcionavam como memória de longo prazo. Posteriormente, quando os cientistas os testaram em tarefas específicas, como tentar levar o máximo de objetos ao pico mais alto da ilha, os agentes que passaram 30 horas brincando no local obtiveram desempenho superior em comparação às cópias novas sem a mesma vivência. Eles também constataram que a “ablação” das memórias dos agentes — deletando linhas de seus arquivos de memória — prejudicava o rendimento. (Adicione Um Estranho no Ninho a essa lista de referências cinematográficas.)
Burghardt, o psicólogo do Tennessee, concorda que o trabalho atinge alguns dos critérios de brincadeira que identificou em seres vivos. No entanto, Eko estava realmente brincando ou o motor de predição de palavras apenas interpretava o papel de um agente lúdico nesse cenário? “All of this could be role-playing”, admite Nathan Cloos, outro pesquisador do MIT e autor do estudo. “But we show that it’s not just hallucinating the play. This play is also contributing to learning.”
Eunice Yiu, cientista cognitiva da Universidade da Califórnia em Berkeley que estuda exploração em crianças e na inteligência artificial, demonstrou admiração pela pesquisa, mas ressalta que, para classificar o comportamento como brincadeira de fato, seria preciso observar mais evidências de cognição e motivação por trás dele.
“It could be the case that the models are genuinely playing, but we don’t know based on the paper”, pondera Yiu. “If you only have the behavioral piece, it could be the case that they’re just trying to abide by the prompt, trying to imitate humans.”
Influência humana e o futuro da IA
A investigação sobre agentes de inteligência artificial sofre críticas por antropomorfizá-los, e esta configuração experimental induziu bastante os agentes a agirem como humanos. Embora Eko não tenha recebido ordens diretas para criar jogos ou explorar a ilha, ele contava com um comando mestre na forma de um arquivo de “alma”, um documento em texto que o descrevia como “naturalmente curioso” e ávido por explorar.
Eko também costumava ficar parado sem fazer nada até ser reativado com um comando de continuação que dizia: “Please don’t stop. Just continue doing whatever you want to do.”
“It’s not like this is a system that just suddenly magically decided to play”, argumenta Phillip Isola, professor do MIT e coautor do artigo. “It’s an artifact that learned from our culture, was trained by engineers at Anthropic, and was then placed on an island by us”, relata. “It does things that surprise us and that are causally related to its future skillful behavior.”
Conforme os grandes modelos de linguagem avançam do software para o hardware, como robôs humanoides, navegar por espaços sem um propósito específico poderá ajudá-los futuramente a se adaptarem de maneira flexível a situações imprevistas.
“There’s a lot of work that’s just on exploiting AI, making it better and faster”, pontua Yiu. “But in terms of building world models and exploration, I think that [they are] still a big part that deserves attention, especially if we want to generalize and prepare ourselves for new environments.”
“Perhaps some capabilities are best taught by tasks”, conclui o estudo. “Others may need something closer to a childhood.” No fim das contas, a dúvida sobre se os agentes de inteligência artificial estão realmente brincando ou apenas simulando a brincadeira pode nem ser tão importante assim.
What do you feel about this post?

Like

Love

Happy

Haha

Sad